Optimisation Llm
18 article(s)mon petit outil perso pour coacher Claude
📖 Lire sur Vigie24L'auteur présente un outil personnel conçu pour optimiser et guider les interactions avec l'IA Claude. L'objectif est d'améliorer la qualité des réponses via un système de coaching ou de prompt engineering structuré.
 France
· 17/10/2026 18:36 ·
⚙️ 984 tok
Score : 66.0 ⓘ


Arrête de tout faire avec un seul agent IA (sous-agents Hermes)
📖 Lire sur Vigie24L'article critique l'utilisation d'un agent IA unique pour des tâches complexes et préconise l'adoption d'une architecture multi-agents via les sous-agents Hermes. Cette approche permet une meilleure spécialisation et une efficacité accrue dans l'exécution des workflows.
 Tunisie
· 13/10/2026 07:00 ·
⚙️ 954 tok
Score : 75.4 ⓘ

I Made My Local AI Pick Its Own Model
📖 Lire sur Vigie24L'auteur présente un système d'IA locale capable de sélectionner dynamiquement le modèle LLM le plus approprié pour répondre à une requête spécifique. Cette approche d'orchestration permet d'optimiser les ressources matérielles tout en maximisant la qualité des réponses.
 États-Unis
· 05/10/2026 17:21 ·
⚙️ 950 tok
Score : 71.1 ⓘ

【PODCAST】IA en local & Hermes Agent : les tips qui dont la différence (partie 2)
📖 Lire sur Vigie24Ce podcast explore les techniques d'optimisation pour l'exécution de modèles d'IA en local et présente Hermes Agent. L'échange se concentre sur les astuces pratiques pour améliorer les performances et l'efficacité des agents IA autonomes.
France
· 24/09/2026 16:00 ·
⚙️ 960 tok
Score : 71.1 ⓘ

Grâce à Bonsai 2 27B, PrismML réduit Qwen3.8 27B à 5,9 Go pour l'IA locale, en pariant que les LLM capables de raisonnement et hautement performants ne doivent pas nécessairement être volumineux
📖 Lire sur Vigie24PrismML a lancé Ternary Bonsai 2 27B, une version compressée du modèle Qwen3.8 27B réduite à 5,9 Go. Cette optimisation permet de maintenir 98,2 % des performances initiales tout en facilitant le déploiement de l'IA en local.
France
· 21/09/2026 00:20 ·
⚙️ 1 282 tok
Score : 73.1 ⓘ

Un projet de 158 agents complet pour Claude
📖 Lire sur Vigie24Présentation d'un projet proposant une bibliothèque de 158 agents spécialisés pour l'IA Claude. L'objectif est d'optimiser les performances de l'assistant via des configurations d'agents prédéfinies.
France
· 20/09/2026 14:28 ·
⚙️ 939 tok
Score : 59.4 ⓘ
The Power of Ensemble Retrieval: Why Diversity Beats Accuracy in Enterprise RAG
📖 Lire sur Vigie24Cet article explique comment concevoir un système RAG hybride pour entreprise en utilisant LangGraph. Il combine la recherche vectorielle, le BM25, le Reciprocal Rank Fusion et le re-ranking via cross-encoder pour optimiser la précision des résultats.
 Inde
· 27/08/2026 00:00 ·
⚙️ 1 057 tok
Score : 71.1 ⓘ
Azure Content Understanding: Benchmarking Semantic Chunking for Enterprise RAG
📖 Lire sur Vigie24Cet article présente un benchmark sur le découpage sémantique (semantic chunking) via Azure Content Understanding pour optimiser les systèmes RAG en entreprise. L'analyse se concentre sur la précision de la récupération, la qualité du contexte, la latence et les coûts de traitement.
Inde
· 26/08/2026 08:19 ·
⚙️ 1 007 tok
Score : 68.0 ⓘ
Azure Content Understanding: Benchmarking Semantic Chunking for Enterprise RAG
📖 Lire sur Vigie24Cet article présente un benchmark sur le découpage sémantique (semantic chunking) via Azure Content Understanding pour optimiser les systèmes RAG en entreprise. L'analyse mesure l'impact de cette technique sur la précision de la récupération, la qualité du contexte, la latence et les coûts de traitement.
Inde
· 26/08/2026 00:00 ·
⚙️ 1 009 tok
Score : 70.0 ⓘ
Fine-tuning contextual LLMs for enterprise workflows
📖 Lire sur Vigie24L'article présente une stratégie hybride combinant le fine-tuning (LoRA/QLoRA) et le RAG pour automatiser le transfert de données entre Jira et SAP. Cette approche permet d'atteindre une précision de 99,4 % dans la génération de schémas tout en intégrant des contrôles de sécurité via l'intervention humaine.
Inde
· 25/08/2026 00:00 ·
⚙️ 1 134 tok
Score : 68.0 ⓘ

Demandez à l'IA de poser des questions avant TOUT ! #shorts
📖 Lire sur Vigie24L'auteur conseille d'inviter l'IA à poser des questions de clarification avant de générer une réponse. Cette méthode permet d'affiner le contexte et d'obtenir un résultat beaucoup plus précis et pertinent.
France
· 14/08/2026 09:59 ·
⚙️ 781 tok
Score : 57.5 ⓘ

Transformez vos prompts ratés en succès avec le Meta Aspect ! #shorts
📖 Lire sur Vigie24Cette vidéo présente la technique du 'Meta Aspect' pour optimiser les prompts d'IA. Elle explique comment transformer des résultats insatisfaisants en succès en demandant à l'IA d'analyser et d'améliorer sa propre approche.
France
· 09/08/2026 15:55 ·
⚙️ 788 tok
Score : 57.5 ⓘ
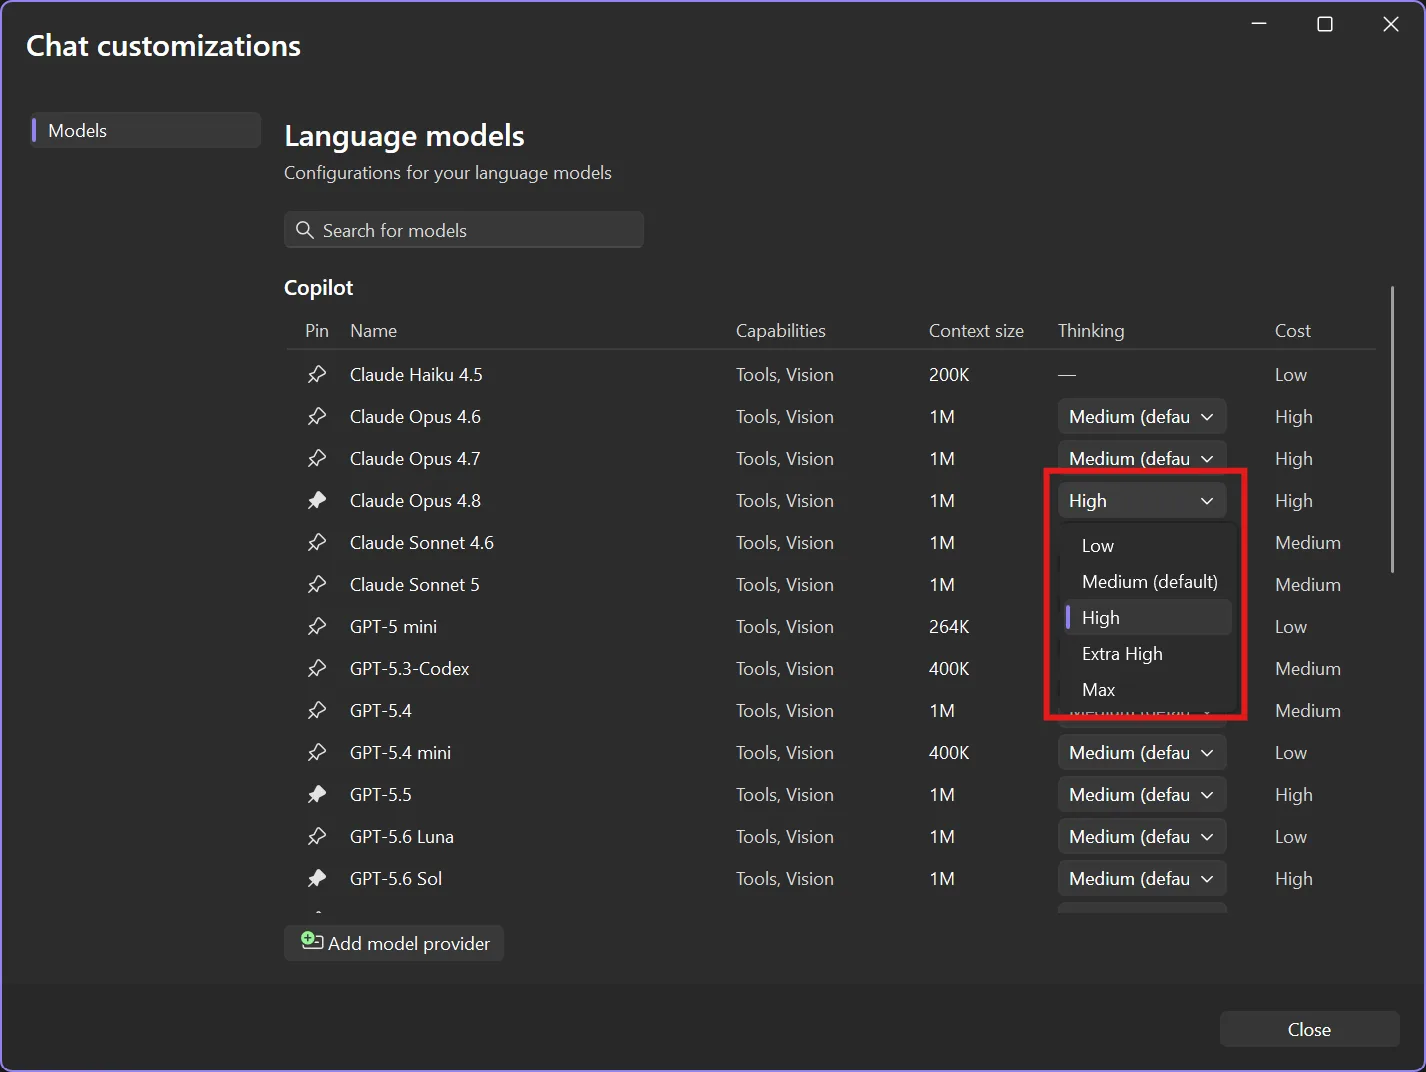
Tell your model when to think harder
📖 Lire sur Vigie24Visual Studio 18.9 Insiders 2 introduit une fonctionnalité permettant d'ajuster le niveau de réflexion des modèles d'IA selon la complexité de la tâche. L'objectif est d'optimiser les ressources en différenciant les requêtes simples, comme le renommage de variables, des problèmes complexes comme le débogage de fuites de mémoire.
États-Unis
· 29/07/2026 15:02 ·
⚙️ 1 008 tok
Score : 57.5 ⓘ

vLLM - 03. Notions & Définitions
📖 Lire sur Vigie24Cette ressource présente les concepts fondamentaux et les définitions techniques liés à vLLM, une bibliothèque optimisée pour le déploiement de modèles de langage. Elle détaille les mécanismes permettant d'améliorer l'efficacité de l'inférence et la gestion de la mémoire.
France
· 21/07/2026 19:39 ·
⚙️ 619 tok
Score : 63.0 ⓘ

Reflection Design Pattern IA: 10x meilleurs résultats
📖 Lire sur Vigie24L'article présente le 'Reflection Design Pattern', une technique permettant aux LLM d'auto-critiquer et d'améliorer leurs propres réponses. Cette approche itérative vise à réduire les hallucinations et à augmenter significativement la qualité des résultats produits par l'IA.
France
· 03/02/2026 08:00 ·
⚙️ 692 tok
Score : 63.0 ⓘ

Design Pattern Routeur : Optimiser vos Agents IA et réduire les coûts
📖 Lire sur Vigie24L'article présente le design pattern 'Routeur' pour l'orchestration d'agents IA, permettant de diriger les requêtes vers le modèle le plus adapté. Cette approche vise à optimiser les performances techniques tout en réduisant significativement les coûts opérationnels.
France
· 25/01/2026 16:25 ·
⚙️ 956 tok
Score : 61.4 ⓘ
Advanced Prompt Engineering for Productivity
📖 Lire sur Vigie24Ce guide propose des techniques avancées de prompt engineering pour optimiser la productivité et la créativité. Il inclut plus de 500 prompts prêts à l'emploi destinés aux développeurs, étudiants et professionnels.
Inde
· 29/09/2025 00:00 ·
⚙️ 806 tok
Score : 55.5 ⓘ
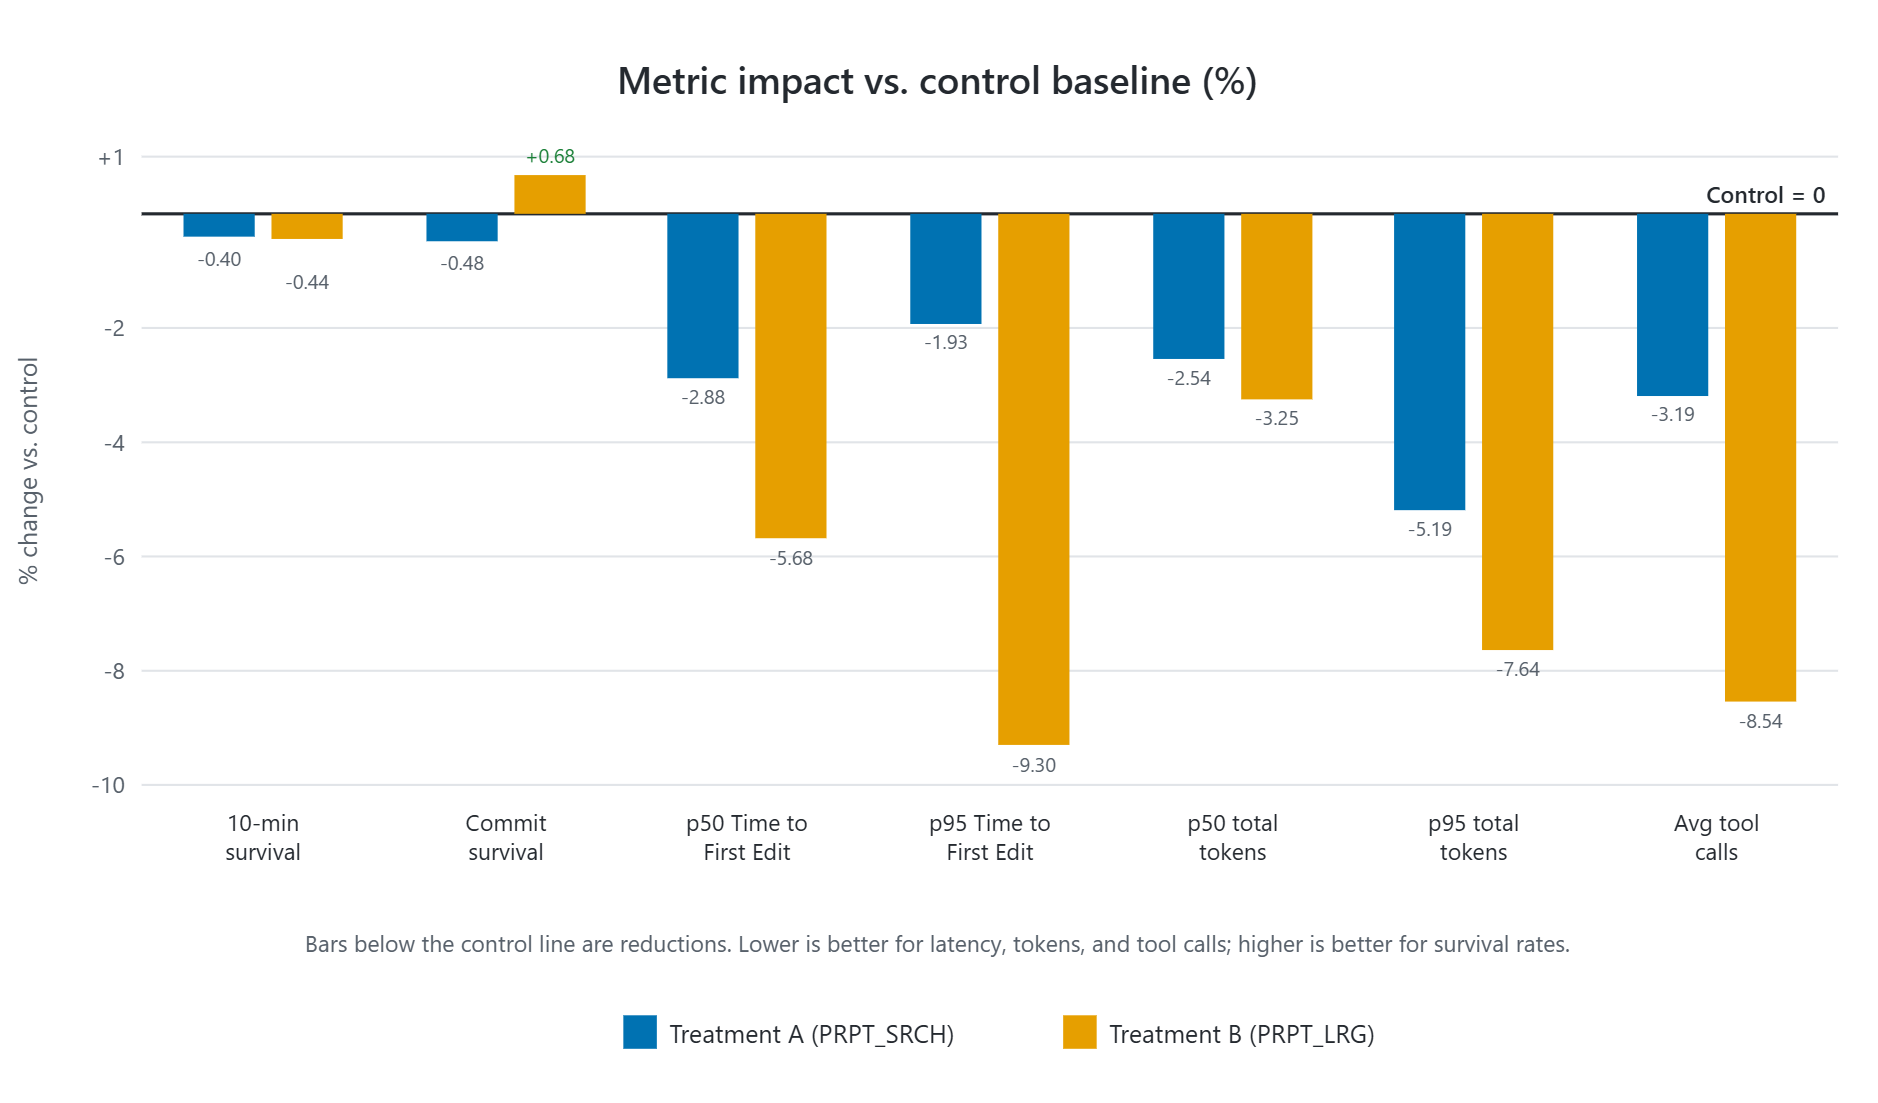
How Prompt Tuning Improved GPT-5.5 in VS Code
📖 Lire sur Vigie24L'article détaille comment l'optimisation du prompt tuning a permis d'améliorer les performances du modèle GPT-5.5 au sein de l'environnement VS Code. Il explique les ajustements techniques apportés pour optimiser l'intégration des fournisseurs de modèles dans le harnais de codage.
États-Unis
· 01/01/0001 00:00 ·
⚙️ 826 tok
Score : 63.0 ⓘ