Extraction De Donnees
6 article(s)Extraction de la mise en page avec Tesseract et PyMuPDF : 200 pages en 10 à 30 s, est-ce rapide ?
📖 Lire sur Vigie24L'auteur s'interroge sur la performance d'un pipeline d'extraction de mise en page utilisant Tesseract et PyMuPDF, traitant 200 pages en 10 à 30 secondes. Le contenu semble être une discussion technique sur l'optimisation de l'OCR et du parsing de documents.
 Canada
· 08/10/2026 14:55 ·
⚙️ 1 040 tok
Score : 61.3 ⓘ
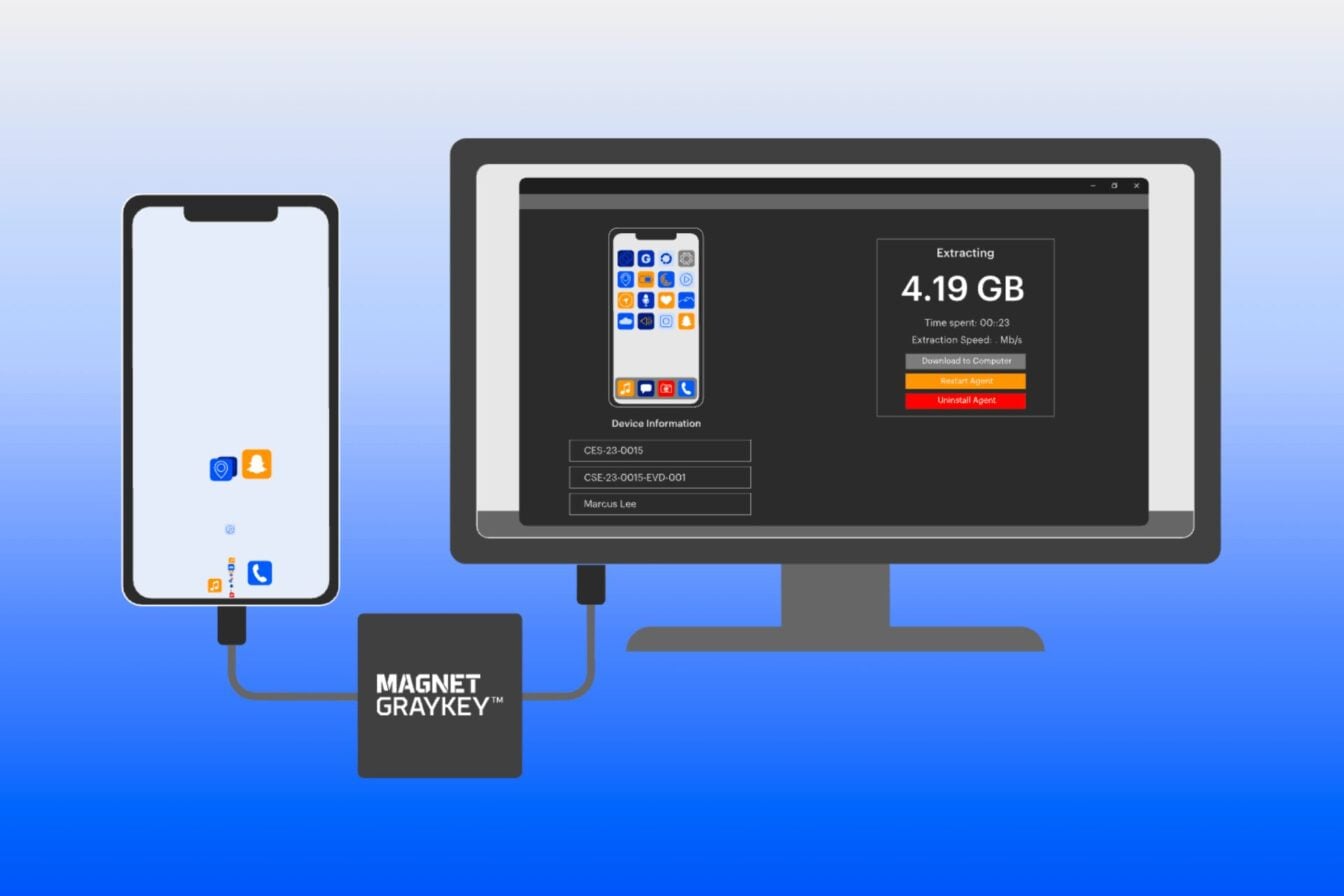
La protection anti-police de l’iPhone contournée, la parade d’Apple serait tombée
📖 Lire sur Vigie24Une nouvelle méthode permettrait de contourner le mécanisme de redémarrage automatique des iPhones verrouillés, conçu pour bloquer les logiciels d'extraction de données. Cette faille pourrait faciliter le travail des services d'enquête pour accéder aux données cryptées.
 France
· 02/10/2026 14:00 ·
⚙️ 1 026 tok
Score : 74.2 ⓘ

FxTwitter - L'API gratuite pour lire X sans compte
📖 Lire sur Vigie24Le projet open source FxTwitter propose une API gratuite permettant d'accéder aux contenus publics de X (posts, vidéos, flux RSS) au format JSON sans nécessiter de compte ni de clé API. Cette solution alternative devient particulièrement utile suite à la disparition de Nitter.
France
· 25/09/2026 09:34 ·
⚙️ 1 049 tok
Score : 75.0 ⓘ


Transforme n'importe quel livre en skill Claude Code. Tu donnes le PDF a Claude Code, il en extrait
📖 Lire sur Vigie24L'article présente une méthode pour transformer un livre au format PDF en compétence spécifique pour Claude Code. L'outil permet d'extraire le contenu du document pour enrichir les capacités de l'assistant IA.
France
· 26/08/2026 09:12 ·
⚙️ 937 tok
Score : 69.5 ⓘ
Azure Content Understanding: Measuring Agentic Document Extraction Accuracy and Cost
📖 Lire sur Vigie24L'article présente une méthodologie pour évaluer Azure Content Understanding dans le cadre de l'extraction agentique de documents. L'analyse se concentre sur quatre indicateurs clés : la précision de l'extraction, le coût de traitement, la latence et la gestion des documents complexes.
 Inde
· 26/08/2026 08:20 ·
⚙️ 1 001 tok
Score : 68.0 ⓘ
Azure Content Understanding: Measuring Agentic Document Extraction Accuracy and Cost
📖 Lire sur Vigie24L'article présente une méthode d'évaluation d'Azure Content Understanding pour l'extraction agentique de documents. L'analyse se concentre sur la précision de l'extraction, les coûts de traitement, la latence et la gestion des documents complexes.
Inde
· 26/08/2026 00:00 ·
⚙️ 978 tok
Score : 64.5 ⓘ