Performance Ia
16 article(s)
Meta dépasse OpenAI et Google grâce à son nouveau modèle d’IA « Muse Wonder Full »
📖 Lire sur Vigie24Meta a lancé un nouveau modèle d'IA nommé Muse Wonder Full. Selon le classement d'Artificial Analysis, ce modèle surpasse ceux d'OpenAI et de Google, se plaçant juste derrière Claude Opus 5.5 d'Anthropic.
 France
· 14/10/2026 10:34 ·
⚙️ 1 024 tok
Score : 69.9 ⓘ

« Nous sommes déçus de Mistral » : le moteur de recherche Ecosia abandonne l’IA française pour des modèles chinois
📖 Lire sur Vigie24Le moteur de recherche Ecosia a décidé d'abandonner les modèles de Mistral AI au profit de solutions chinoises, jugeant les performances de l'IA française insuffisantes. Le dirigeant d'Ecosia justifie également ce choix par des préoccupations liées à l'énergie nucléaire et à la souveraineté numérique.
France
· 09/10/2026 12:01 ·
⚙️ 1 087 tok
Score : 73.4 ⓘ
Mistral répond aux critiques du moteur de recherche allemand Ecosia, qui vient de lui claquer la porte
📖 Lire sur Vigie24Le moteur de recherche Ecosia a décidé d'arrêter d'utiliser les modèles de Mistral AI, critiquant leurs performances. Mistral a réagi en suggérant à Ecosia de tester son nouveau modèle, Mistral Large 4.
France
· 09/10/2026 11:02 ·
⚙️ 1 042 tok
Score : 72.6 ⓘ
AHOY Labs (alias Trouvé) annonce ses résultats à EnterpriseRAG-Bench : 1,03 document non pertinent par réponse
📖 Lire sur Vigie24AHOY Labs (Trouvé) a publié ses performances sur le benchmark EnterpriseRAG-Bench, affichant un taux de réponses correctes de 79,6 %. L'entreprise souligne également une grande précision avec seulement 1,03 document non pertinent par réponse.
 Canada
· 06/10/2026 14:52 ·
⚙️ 1 179 tok
Score : 68.7 ⓘ


JEV : la nouvelle IA 200 fois plus rapide que les autres
📖 Lire sur Vigie24L'article présente JEV, une nouvelle intelligence artificielle qui se distingue par une vitesse de traitement 200 fois supérieure aux modèles existants. Cette avancée promet d'optimiser considérablement les performances de génération et d'exécution des tâches IA.
France
· 30/09/2026 09:19 ·
⚙️ 952 tok
Score : 67.6 ⓘ
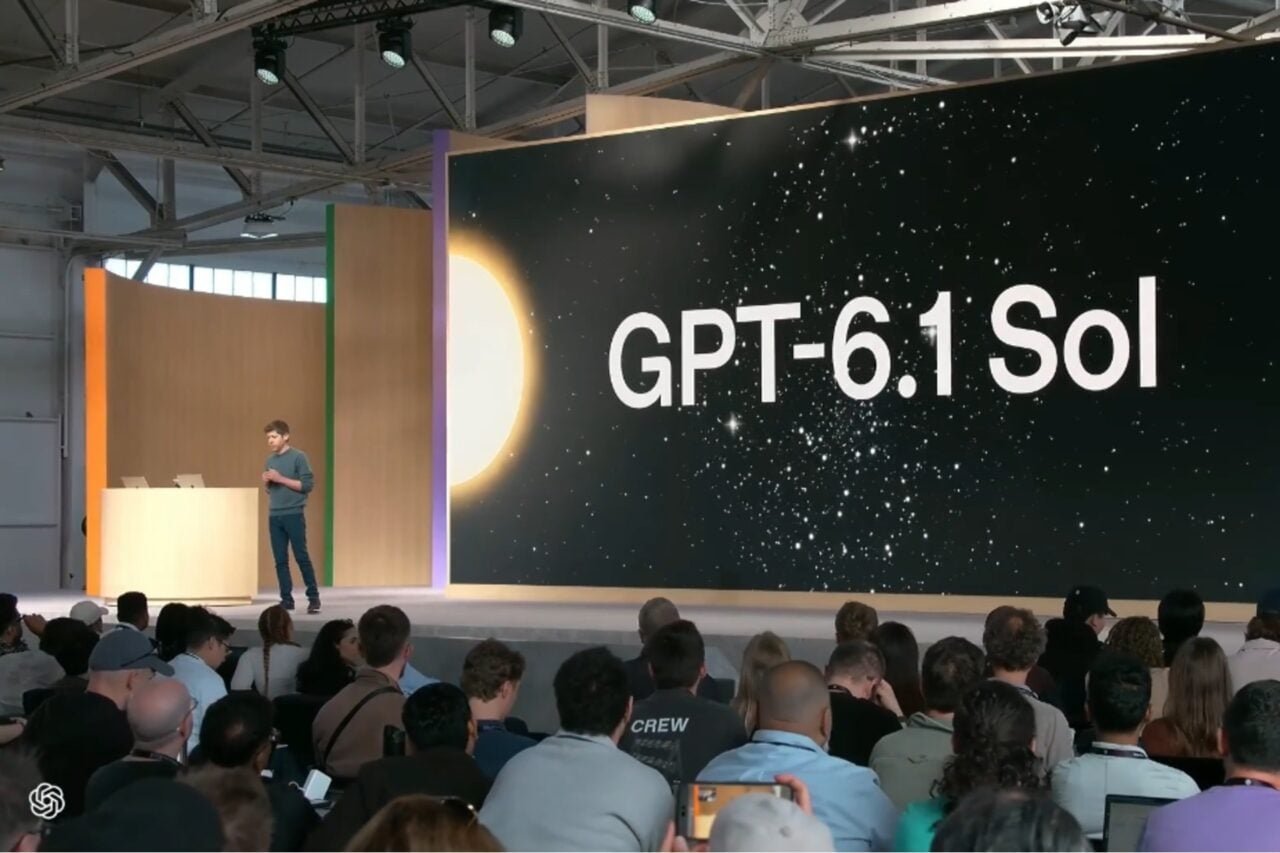
OpenAI lance une IA 5 fois moins chère, mais presque aussi puissante que GPT-6 Astra
📖 Lire sur Vigie24OpenAI a introduit GPT-6.1 Sol, un nouveau modèle conçu pour alimenter ses agents Dots. Ce modèle offre des performances proches de GPT-6 Astra tout en étant cinq fois moins coûteux.
France
· 29/09/2026 20:47 ·
⚙️ 1 039 tok
Score : 79.7 ⓘ
Claude vient de faire baisser le coût de vos requêtes : la nouvelle IA Sonnet 5.5 est 30 % moins chère, mais presque aussi puissante qu’Opus 5.5
📖 Lire sur Vigie24Anthropic a lancé Claude Sonnet 5.5, un nouveau modèle d'IA plus rapide et 30 % moins coûteux que la version précédente. Malgré cette baisse de prix, il conserve des performances très élevées, se classant juste derrière Claude Opus 5.5.
France
· 29/09/2026 08:27 ·
⚙️ 1 060 tok
Score : 79.3 ⓘ

Fireworks AI lance Ember-1, un modèle d'IA spécialisé basé sur l'architecture Kimi K3 qui réduit la consommation de jetons de 40 % tout en préservant la qualité des réponses
📖 Lire sur Vigie24Fireworks AI a dévoilé Ember-1, un modèle d'IA basé sur l'architecture Kimi K3. Ce modèle se distingue par sa capacité à réduire la consommation de jetons de 40 % tout en maintenant un niveau de performance élevé.
France
· 28/09/2026 10:43 ·
⚙️ 1 199 tok
Score : 80.5 ⓘ

DeepSeek V4.1 vs Qwen 3.8 Flash : un seul survit (60 tests)
📖 Lire sur Vigie24L'article propose un comparatif technique rigoureux entre DeepSeek V4.1 et Qwen 3.8 Flash à travers une série de 60 tests. L'objectif est de déterminer lequel de ces deux modèles LLM offre les meilleures performances globales.
France
· 25/09/2026 15:39 ·
⚙️ 963 tok
Score : 76.2 ⓘ

OpenAI lance GPT-6 Sol et Luna, deux modèles qui se distinguent par un coût réduit et moins d'erreurs que leurs prédécesseurs, et succèdent à GPT-6 Astra
📖 Lire sur Vigie24OpenAI a introduit GPT-6 Sol et GPT-6 Luna, deux nouveaux modèles succédant à GPT-6 Astra. Ces versions se distinguent par un coût réduit et une meilleure précision, Sol étant dédié aux tâches quotidiennes et Luna optimisé pour la rapidité et le volume.
France
· 23/09/2026 11:22 ·
⚙️ 1 192 tok
Score : 80.5 ⓘ

Anthropic lance Claude Opus 5.5, offrant des performances comparables à Claude Fable 5.1 et un coût d'exploitation inférieur de 40 % à Opus 5 pour les charges de travail types
📖 Lire sur Vigie24Anthropic a dévoilé Claude Opus 5.5, le premier modèle de sa nouvelle gamme 5.5. Ce modèle maintient des performances similaires à Claude Fable 5.1 tout en réduisant les coûts d'exploitation de 40 % par rapport à Opus 5.
France
· 23/09/2026 11:20 ·
⚙️ 1 209 tok
Score : 80.5 ⓘ

GPT-6 Sol ne vaut TOUJOURS pas son prix (800 tests)
📖 Lire sur Vigie24L'auteur analyse les performances du GPT-6 Sol à travers 800 tests pour déterminer si le produit justifie son coût. Le verdict final suggère que l'investissement n'est pas rentable au regard des résultats obtenus.
France
· 23/09/2026 09:44 ·
⚙️ 946 tok
Score : 66.4 ⓘ

ChatGPT vs Claude : OpenAI et Anthropic dégainent des IA moins chers et plus efficaces… au lieu de ralentir
📖 Lire sur Vigie24OpenAI et Anthropic intensifient leur concurrence en lançant des modèles d'IA plus performants et moins coûteux, notamment GPT-6 Sol, Luna et Claude Opus 5.5. Cette offensive commerciale intervient alors que des débats font état d'un possible ralentissement du secteur.
France
· 23/09/2026 06:17 ·
⚙️ 1 066 tok
Score : 73.4 ⓘ

Claude Opus 5.5 rend Fable 5.1 INUTILE (+1000 tests)
📖 Lire sur Vigie24L'auteur compare les performances de Claude Opus 5.5 face à Fable 5.1 à travers plus de 1000 tests. Les résultats suggèrent que le nouveau modèle d'Anthropic surpasse largement son concurrent, rendant ce dernier obsolète.
France
· 22/09/2026 19:20 ·
⚙️ 982 tok
Score : 69.9 ⓘ
Azure Content Understanding: Measuring Agentic Document Extraction Accuracy and Cost
📖 Lire sur Vigie24L'article présente une méthodologie pour évaluer Azure Content Understanding dans le cadre de l'extraction agentique de documents. L'analyse se concentre sur quatre indicateurs clés : la précision de l'extraction, le coût de traitement, la latence et la gestion des documents complexes.
 Inde
· 26/08/2026 08:20 ·
⚙️ 1 001 tok
Score : 68.0 ⓘ

Anthropic vient de tuer son propre modèle (Claude Opus 5)
📖 Lire sur Vigie24L'article analyse la sortie d'un nouveau modèle d'Anthropic qui rendrait son prédécesseur, Claude Opus, obsolète en termes de performance et d'efficacité. Cette évolution marque une accélération du cycle de renouvellement des LLM.
France
· 28/07/2026 06:17 ·
⚙️ 804 tok
Score : 57.5 ⓘ