Llm
37 article(s)

Veille #78 - Anthropic quitte git, Mistral Large 4 à 1T paramètres, OpenCode 2.0 lance ses subagents, et 28 autres actus IA
📖 Lire sur Vigie24Cette veille technologique recense les dernières actualités de l'IA, notamment le départ d'Anthropic de Git, les spécifications de Mistral Large 4 et le lancement des subagents d'OpenCode 2.0. Elle propose un tour d'horizon complet de 32 actualités récentes du secteur.
 France
· 16/10/2026 11:38 ·
⚙️ 1 044 tok
Score : 73.5 ⓘ
LiteLLM : deux failles permettaient de voler des clés API d'IA et de prendre le contrôle de serveurs
📖 Lire sur Vigie24Deux vulnérabilités critiques ont été découvertes dans LiteLLM, une passerelle connectant diverses API d'IA. Ces failles permettaient à des utilisateurs avec des accès limités de voler des clés API ou de prendre le contrôle total des serveurs.
France
· 16/10/2026 08:59 ·
⚙️ 1 117 tok
Score : 78.5 ⓘ

Llama - L'IA locale de llama.cpp, sans ligne de commande
📖 Lire sur Vigie24L'équipe de llama.cpp propose une application Windows 11 permettant d'utiliser des modèles GGUF localement sans passer par la ligne de commande. L'outil offre un accès rapide via un raccourci clavier et une gestion simplifiée des modèles depuis la zone de notification.
France
· 16/10/2026 08:04 ·
⚙️ 1 047 tok
Score : 73.8 ⓘ
J'ai demandé à Claude d'utiliser REA pour analyser l'app Android de mon robot balayeuse acheté sur Amazon
📖 Lire sur Vigie24L'auteur relate son expérience d'utilisation de l'IA Claude et de la méthode REA pour analyser le fonctionnement de l'application Android d'un robot aspirateur. L'objectif est de comprendre les mécanismes internes et potentiellement les communications de l'appareil.
 Canada
· 15/10/2026 07:42 ·
⚙️ 1 035 tok
Score : 67.9 ⓘ
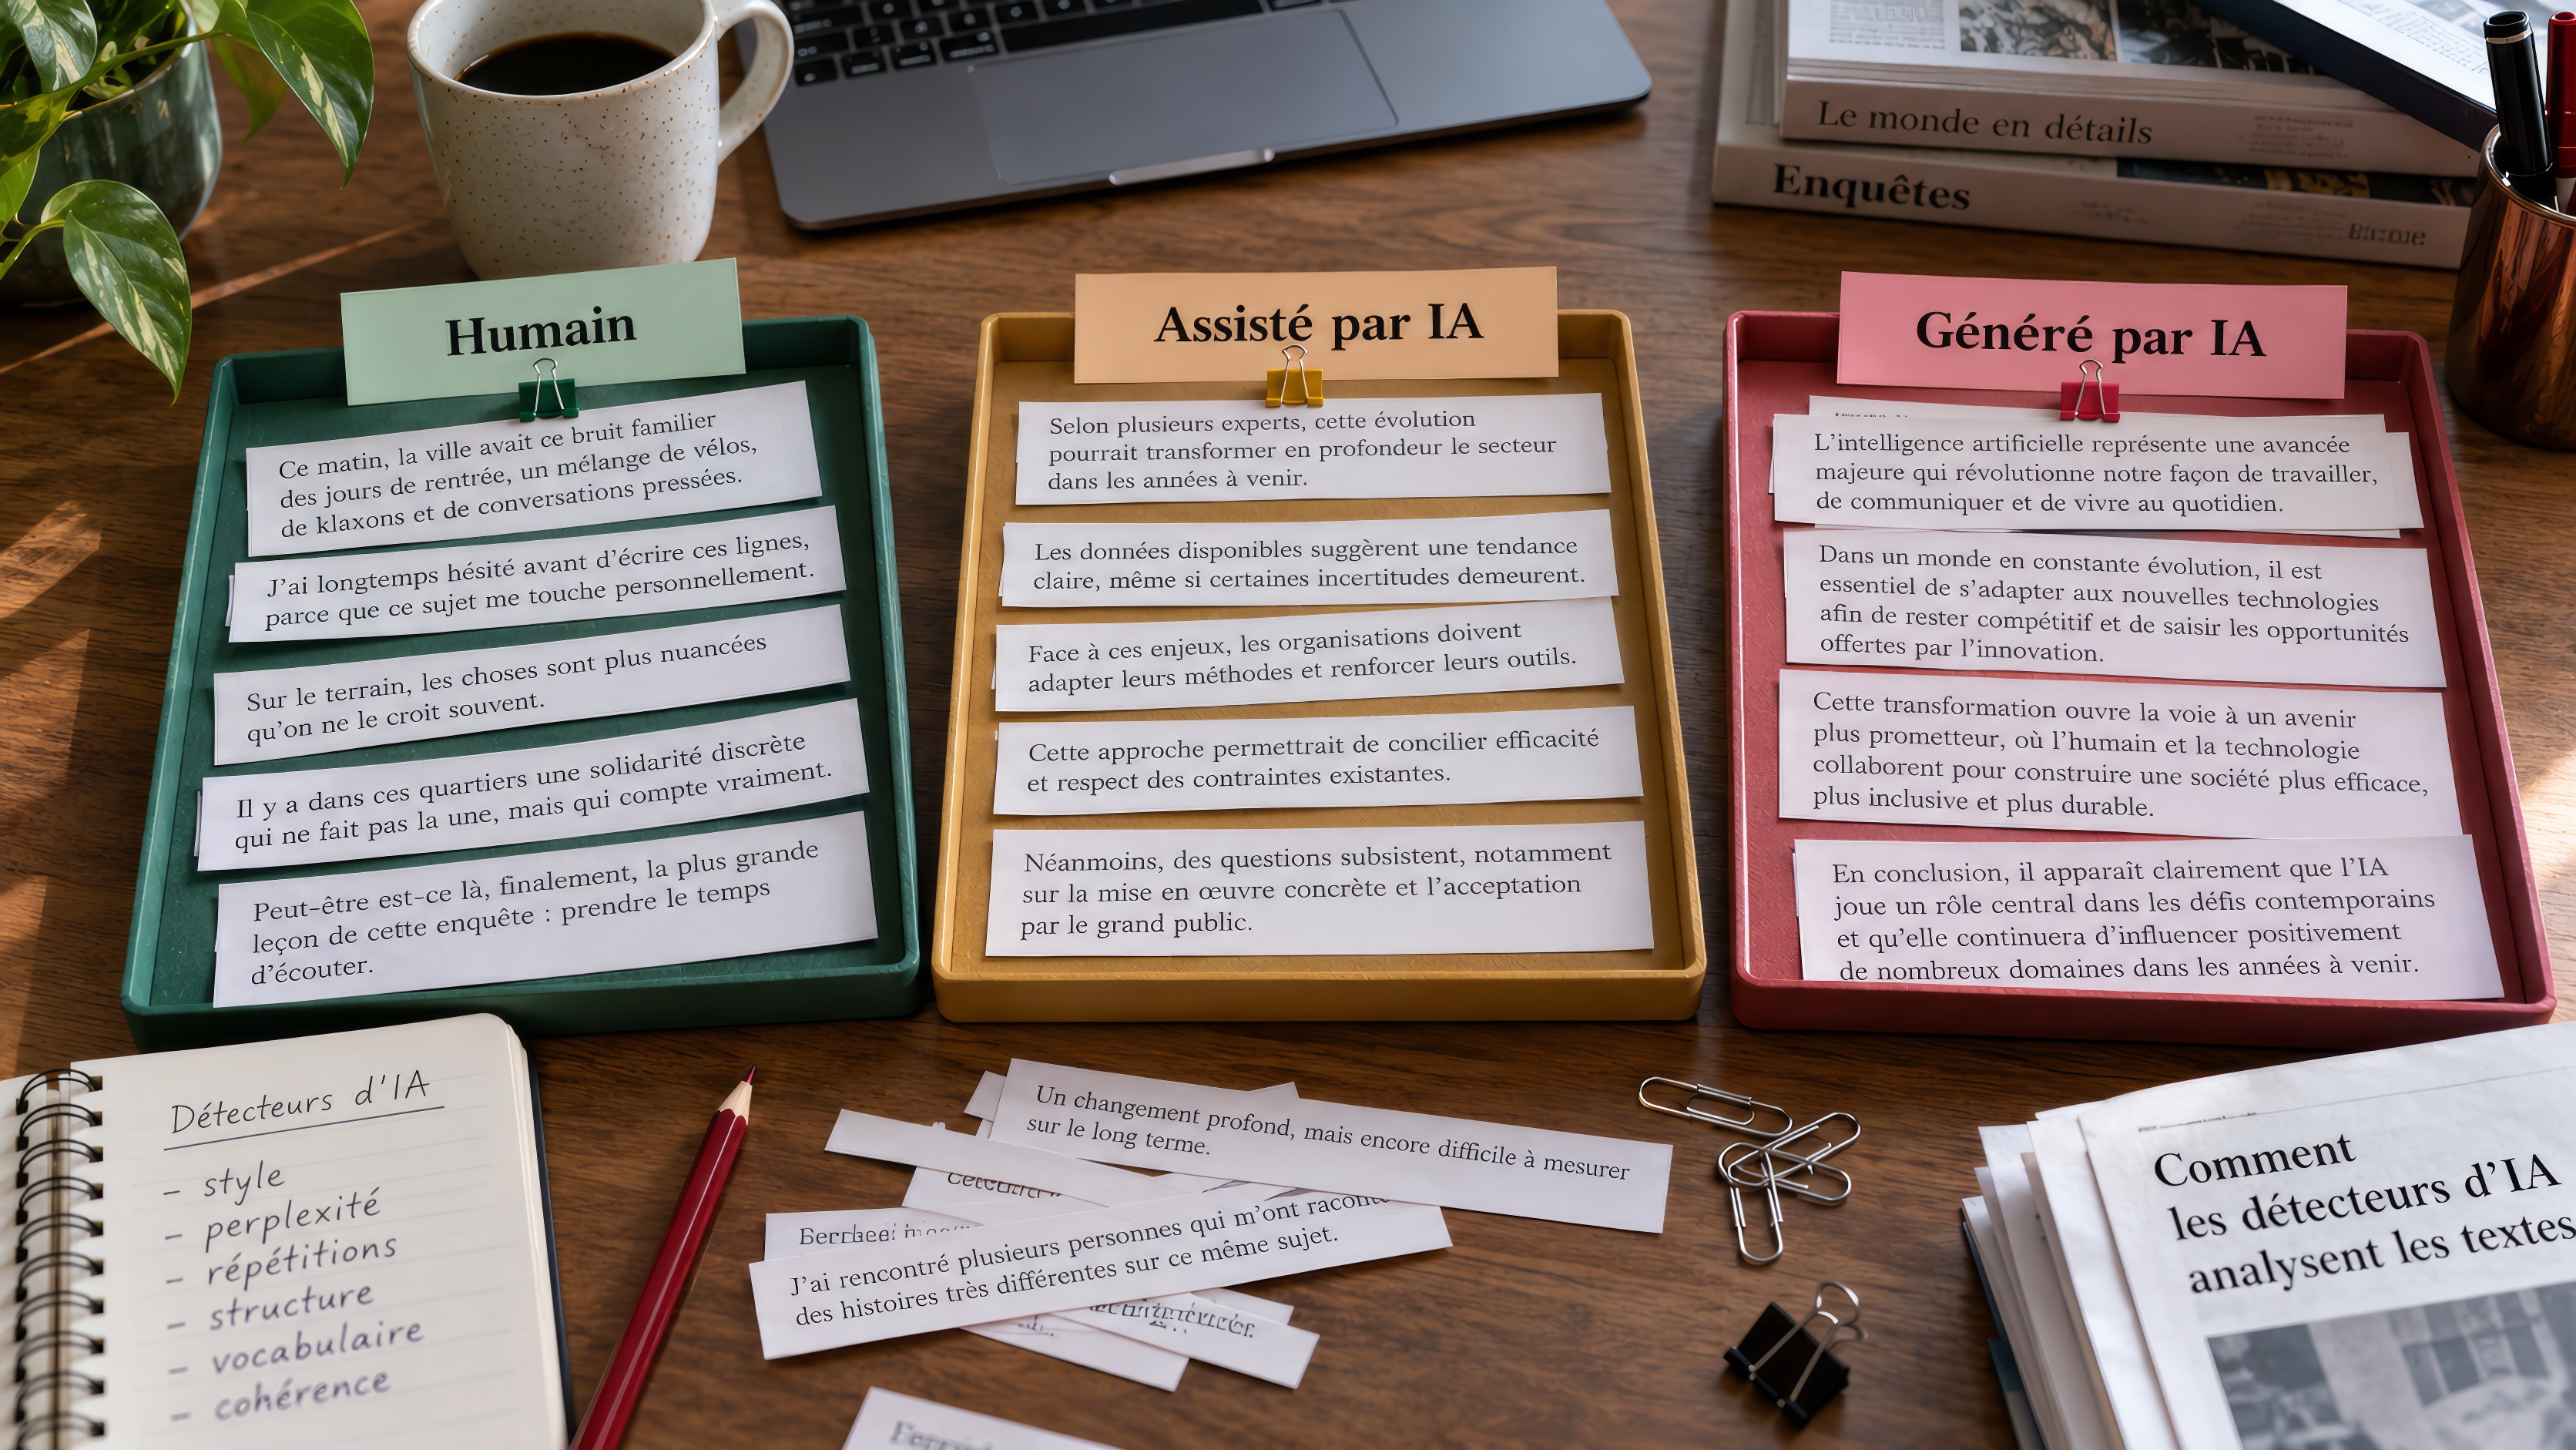
Comment les détecteurs d'IA devinent-ils qu'un texte vient de ChatGPT ?
📖 Lire sur Vigie24L'article explore le fonctionnement technique des détecteurs de contenus générés par IA, tels que Pangram et GPTZero. Il analyse leur efficacité face aux textes purement humains, générés ou hybrides, tout en cherchant à démystifier les mécanismes de verdict.
France
· 10/10/2026 09:45 ·
⚙️ 1 134 tok
Score : 75.0 ⓘ


J’ai remplacé des nodes n8n par JEV : l’IA qui décide (tuto complet)
📖 Lire sur Vigie24Ce tutoriel explique comment optimiser des workflows n8n en remplaçant des nœuds de logique complexes par JEV, une approche basée sur l'IA pour la prise de décision. L'auteur démontre comment déléguer le routage et la logique métier à un LLM pour simplifier la structure des automatisations.
 Tunisie
· 09/10/2026 15:00 ·
⚙️ 998 tok
Score : 69.9 ⓘ

Mistral Large 4, le modèle à 1 000 milliards de paramètres surnommé Le Chonk
📖 Lire sur Vigie24Mistral a dévoilé Mistral Large 4, surnommé « Le Chonk », un modèle massif de 1 000 milliards de paramètres utilisant une architecture MoE avec 49 milliards de paramètres activés. Le modèle sera disponible via API et ses poids seront publiés sur Hugging Face le 27 octobre.
France
· 07/10/2026 09:01 ·
⚙️ 1 108 tok
Score : 79.7 ⓘ

Hermes 0.21 est sorti : j'ai testé les nouveautés… je ne m'attendais pas à ça
📖 Lire sur Vigie24L'auteur teste et analyse les nouveautés de la version 0.21 d'Hermes, un modèle de langage. La vidéo explore les performances et les changements apportés par cette mise à jour.
Tunisie
· 01/10/2026 17:30 ·
⚙️ 973 tok
Score : 66.8 ⓘ
La nouvelle version de Hermes est INCROYABLE… Voici ce qui change 🤯
📖 Lire sur Vigie24L'article présente la nouvelle version du modèle Hermes, mettant en avant ses améliorations significatives en termes de capacités et de performances. Il analyse les changements majeurs apportés à l'architecture ou à l'entraînement pour optimiser les résultats.
Tunisie
· 30/09/2026 14:13 ·
⚙️ 951 tok
Score : 68.0 ⓘ
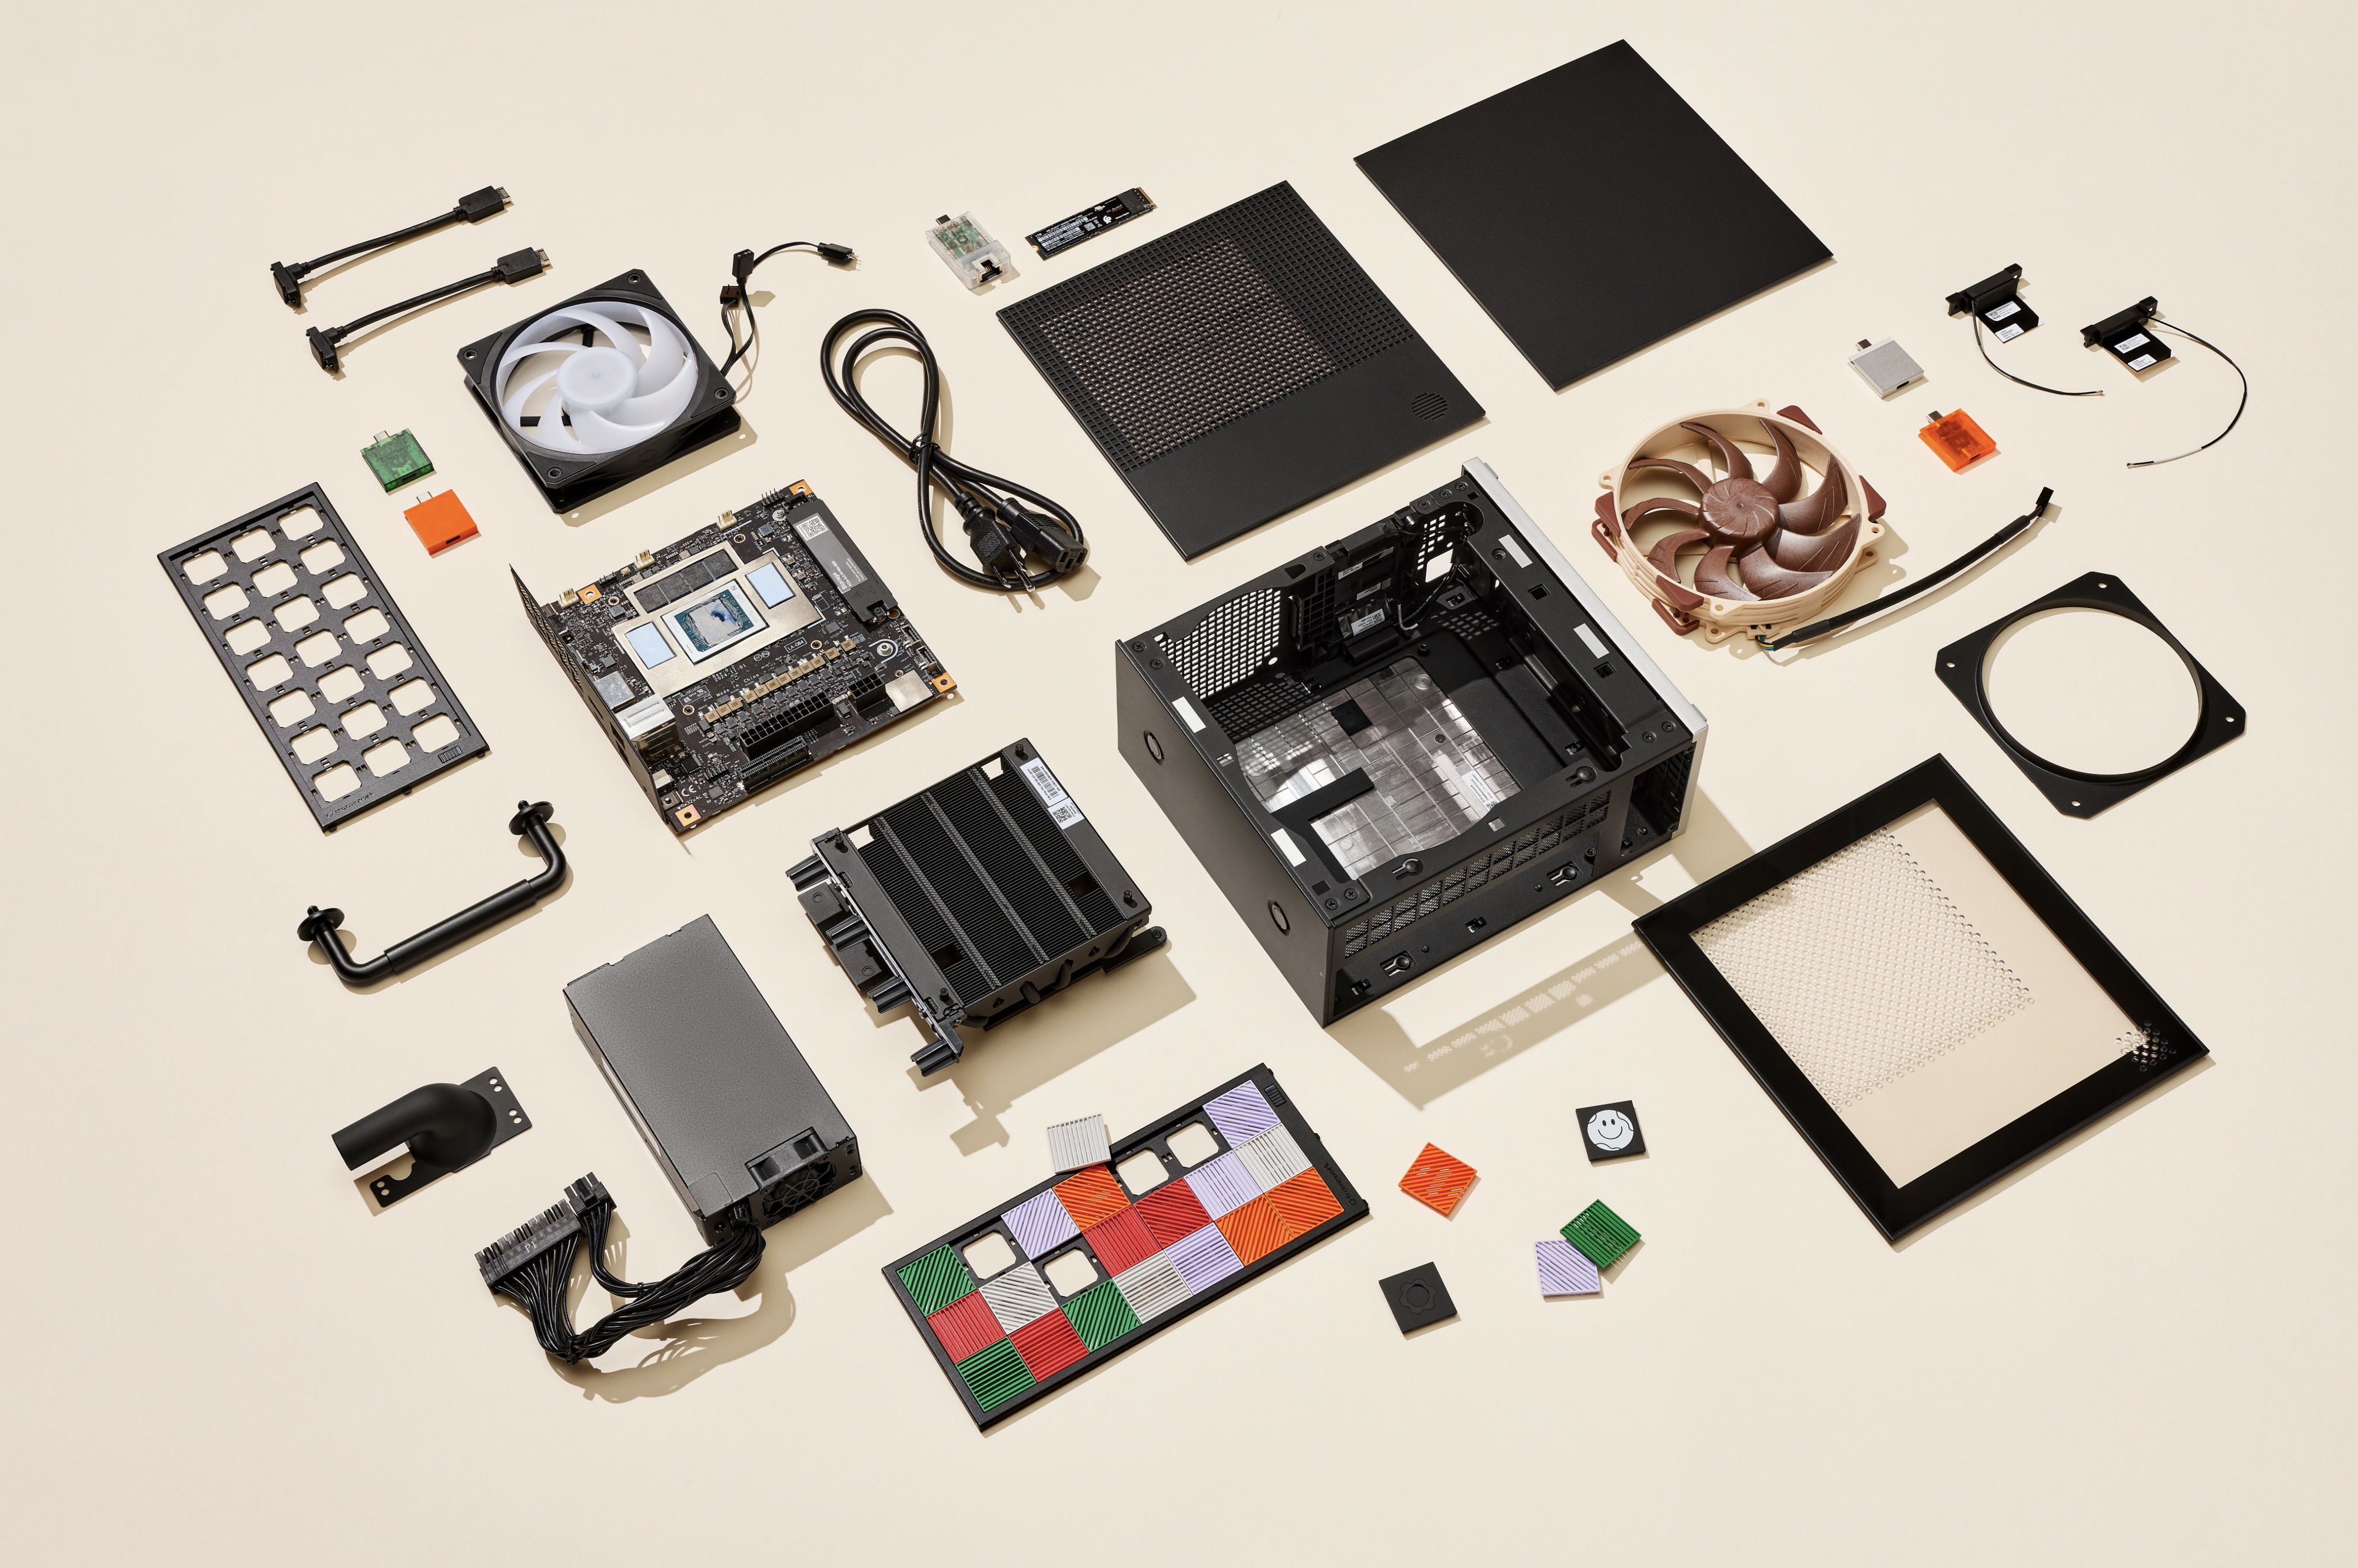
192 Go et Ryzen AI Max+ Pro 495 : le Framework Desktop voué aux LLM bientôt ouvert aux précommandes
📖 Lire sur Vigie24Framework s'apprête à ouvrir les précommandes pour une nouvelle configuration de son Desktop optimisée pour les LLM. Cette machine intègre un processeur Ryzen AI Max+ Pro 495 et jusqu'à 192 Go de mémoire unifiée pour le traitement local de grands modèles de langage.
France
· 29/09/2026 12:51 ·
⚙️ 1 115 tok
Score : 75.0 ⓘ

GLM 5.3 Prime : c'est quoi cette chose
📖 Lire sur Vigie24L'article présente GLM 5.3 Prime, un nouveau modèle de langage performant. Il analyse ses capacités techniques et son positionnement face aux autres LLM du marché.
France
· 24/09/2026 17:00 ·
⚙️ 945 tok
Score : 67.2 ⓘ

Grok 4.7 passé à mon PROTOCOLE de code complet
📖 Lire sur Vigie24L'auteur présente l'utilisation de Grok pour l'implémentation d'un protocole de codage complet. La vidéo explore comment optimiser les capacités de génération de code du modèle pour améliorer la productivité du développement.
France
· 22/09/2026 10:16 ·
⚙️ 952 tok
Score : 61.7 ⓘ
Le roman phénomène de la rentrée littéraire est accusé d’être généré par IA : pourquoi on ne pourra jamais savoir ?
📖 Lire sur Vigie24Le roman 'C'était ça ou mourir' de Thélyson Orélien est soupçonné d'avoir été rédigé par une intelligence artificielle après l'utilisation d'un détecteur. L'article souligne l'impossibilité technique de prouver avec certitude l'origine humaine ou synthétique d'un texte.
France
· 22/09/2026 10:15 ·
⚙️ 1 099 tok
Score : 74.6 ⓘ

Google Home laisse ChatGPT et Claude piloter votre maison
📖 Lire sur Vigie24Google Home permet désormais aux abonnés Premium Advanced aux États-Unis de piloter leurs appareils Matter et caméras Nest via ChatGPT et Claude. Cette intégration s'appuie sur l'utilisation d'un serveur MCP.
France
· 17/09/2026 13:26 ·
⚙️ 1 007 tok
Score : 59.9 ⓘ

DeepSeek lâche une bombe : V4.1 Flash (actu)
📖 Lire sur Vigie24L'article présente le lancement de DeepSeek V4.1 Flash, une nouvelle itération du modèle d'IA visant à optimiser la rapidité et l'efficacité. Cette mise à jour marque une étape importante dans la compétition des modèles LLM performants et accessibles.
France
· 16/09/2026 15:45 ·
⚙️ 971 tok
Score : 64.6 ⓘ

GPT-6 Astra vs Fable 5.1 : qui est le meilleur pour vos projets ?
📖 Lire sur Vigie24L'article propose un comparatif entre deux modèles d'intelligence artificielle, GPT-6 Astra et Fable 5.1, pour aider les utilisateurs à choisir l'outil le plus adapté à leurs projets. Il analyse les performances et les spécificités de chaque modèle.
France
· 09/09/2026 17:54 ·
⚙️ 967 tok
Score : 71.5 ⓘ

GPT-6 Astra VS Fable 5.1 : lequel tu dois utiliser ? (actu IA)
📖 Lire sur Vigie24L'article propose un comparatif entre deux modèles d'intelligence artificielle, GPT-6 Astra et Fable 5.1, pour aider l'utilisateur à choisir l'outil le plus adapté à ses besoins. Il analyse les performances et les fonctionnalités respectives de ces deux solutions.
France
· 09/09/2026 15:45 ·
⚙️ 979 tok
Score : 71.5 ⓘ

Claude Code REMPLACE mes 10 dashboards e-commerce
📖 Lire sur Vigie24L'auteur présente l'utilisation de Claude Code pour automatiser l'analyse de données e-commerce, remplaçant ainsi plusieurs tableaux de bord traditionnels. La vidéo démontre comment l'outil peut interagir directement avec le code et les données pour générer des insights en temps réel.
France
· 08/09/2026 10:30 ·
⚙️ 963 tok
Score : 68.0 ⓘ

Sortie de GLM 5.3 Flash
📖 Lire sur Vigie24Annonce du lancement de GLM 5.3 Flash, une nouvelle version optimisée du modèle de langage GLM. Ce modèle vise à offrir des performances accrues avec une latence réduite.
France
· 06/09/2026 09:18 ·
⚙️ 914 tok
Score : 61.8 ⓘ

Speakr - Interrogez toutes vos réunions enregistrées
📖 Lire sur Vigie24Speakr est un outil auto-hébergé permettant de transcrire des réunions, de séparer les voix et d'interroger ses archives en langage naturel. Bien que configurable en local via Ollama et Whisper, l'outil utilise par défaut des API externes pour le traitement des données.
France
· 04/09/2026 12:30 ·
⚙️ 1 058 tok
Score : 75.0 ⓘ

Le Pentagone fait appel à Grok et à ChatGPT à des fins militaires et allonge la liste des cas d'usage de l'IA qui suscitent de vives controverses éthiques, politiques et juridiques
📖 Lire sur Vigie24Le Pentagone a intégré Grok (Starshield AI) et ChatGPT (OpenAI) pour des usages militaires non classifiés. Cette accélération de l'adoption de l'IA au sein du ministère de la Défense américain soulève d'importantes questions éthiques, politiques et juridiques.
France
· 01/09/2026 15:41 ·
⚙️ 1 232 tok
Score : 80.5 ⓘ

4 choses que je construirais dans Claude en un weekend
📖 Lire sur Vigie24L'auteur propose quatre idées de projets concrets à développer rapidement en utilisant les capacités de Claude. Le contenu se concentre sur l'exploitation pratique de l'IA pour créer des outils fonctionnels en un temps record.
France
· 31/08/2026 14:54 ·
⚙️ 936 tok
Score : 69.5 ⓘ
GitHub Copilot Grok 4.6: Benchmarking Agentic Coding and Multi-Step Reasoning
📖 Lire sur Vigie24Cet article présente un benchmark comparant GitHub Copilot et Grok 4.6 sur des capacités de codage agentique et de raisonnement multi-étapes. L'analyse se concentre sur la précision du code, la complétion des tâches et l'impact sur la productivité des développeurs.
 Inde
· 31/08/2026 08:27 ·
⚙️ 1 045 tok
Score : 64.5 ⓘ

Tencent Hy4 : c'est quoi ce monstre ?
📖 Lire sur Vigie24L'article présente le Tencent Hy4, un nouveau modèle d'intelligence artificielle développé par le géant chinois Tencent. Il analyse les capacités techniques et le positionnement de ce modèle face à la concurrence mondiale.
France
· 30/08/2026 15:00 ·
⚙️ 945 tok
Score : 73.5 ⓘ
J’ai installé Claude dans n8n… et c’est complètement bluffant 🤯
📖 Lire sur Vigie24L'auteur présente l'intégration du modèle Claude d'Anthropic au sein de l'outil d'automatisation n8n. Il démontre comment créer des workflows automatisés et intelligents pour optimiser la productivité.
Tunisie
· 28/08/2026 09:00 ·
⚙️ 945 tok
Score : 64.5 ⓘ

IBM lance Granite 4.2, les tout derniers grands modèles de langage de sa gamme à poids ouvert, conçus pour être téléchargés et hébergés en interne, avec des capacités « agentiques » étendues
📖 Lire sur Vigie24IBM a dévoilé Granite 4.2, une nouvelle gamme de modèles de langage à poids ouvert disponibles en trois tailles (3B, 8B et 30B). Ces modèles sont optimisés pour un hébergement interne et possèdent des capacités agentiques étendues.
France
· 27/08/2026 11:03 ·
⚙️ 1 214 tok
Score : 80.5 ⓘ
GitHub Copilot for JetBrains: Testing Memory with Large Enterprise Codebases
📖 Lire sur Vigie24L'article évalue les performances de GitHub Copilot au sein des IDE JetBrains, spécifiquement sur des bases de code d'entreprise volumineuses. L'analyse se concentre sur la rétention du contexte, la pertinence du code généré et l'impact sur le travail de correction des développeurs.
Inde
· 25/08/2026 00:00 ·
⚙️ 953 tok
Score : 64.5 ⓘ

Comprendre le RAG, adapté l'IA à ses documents
📖 Lire sur Vigie24Cette ressource explique le concept de Retrieval-Augmented Generation (RAG), une technique permettant d'optimiser les réponses d'une IA en lui fournissant un accès à des documents externes. Elle détaille comment adapter un modèle de langage à des données spécifiques sans nécessiter un réentraînement complet.
France
· 18/08/2026 13:00 ·
⚙️ 630 tok
Score : 64.7 ⓘ

Connecter Hermes v0.20 à Buzz : 3 heures de galère résumées en 20 minutes
📖 Lire sur Vigie24Cette vidéo technique détaille les étapes pour connecter le modèle Hermes v0.20 à l'interface Buzz, en évitant les pièges courants. L'auteur partage son retour d'expérience pour réduire le temps de configuration de plusieurs heures à vingt minutes. Une ressource utile pour les développeurs travaillant sur l'inférence de modèles open source.
Tunisie
· 07/08/2026 09:00
Score : 61.0 ⓘ

LLMs become botnets by reading websites; Playstation users protest Sony - Talking Heads Ep.440
📖 Lire sur Vigie24L'épisode analyse comment les LLM peuvent involontairement devenir des botnets en interagissant avec des sites web malveillants. Il aborde également les tensions entre Sony et les utilisateurs de PlayStation.
 États-Unis
· 09/07/2026 16:10 ·
⚙️ 627 tok
Score : 54.0 ⓘ
Comprendre le Fonctionnement des LLM : Guide Complet Débutant
📖 Lire sur Vigie24Cette vidéo éducative explique les bases du fonctionnement des modèles de langage (LLM) destinées aux débutants. Elle détaille les concepts clés comme les architectures transformer et le processus d'entraînement. Un guide accessible pour saisir les mécanismes de l'IA générative.
France
· 05/07/2026 15:00
Score : 61.8 ⓘ

Context Engineering : la méthode
📖 Lire sur Vigie24L'article présente la méthode du Context Engineering pour optimiser les interactions avec les LLM. Il explique comment structurer les informations fournies au modèle pour améliorer la précision et la pertinence des réponses générées.
France
· 27/06/2026 15:18 ·
⚙️ 679 tok
Score : 62.6 ⓘ
Installer un LLM en local avec LM Studio (Gemma 4) | tutoriel complet
📖 Lire sur Vigie24Ce tutoriel explique comment installer et configurer un modèle de langage (LLM), spécifiquement Gemma 4, localement sur son ordinateur via l'outil LM Studio. Il détaille les étapes de téléchargement et de mise en œuvre pour utiliser l'IA sans dépendre du cloud.
France
· 19/04/2026 10:39 ·
⚙️ 709 tok
Score : 63.0 ⓘ
Design Pattern Tool Use IA: Pilotez vos LLM Pro
📖 Lire sur Vigie24Cette ressource explore le design pattern 'Tool Use' pour optimiser le pilotage des LLM professionnels. Elle explique comment permettre à une IA d'interagir avec des outils externes pour accroître sa précision et ses capacités opérationnelles.
France
· 07/02/2026 19:12 ·
⚙️ 695 tok
Score : 63.0 ⓘ

Comment créer un RAG avec Google gratuitement ? (tuto complet)
📖 Lire sur Vigie24Ce tutoriel explique comment mettre en place un système de Retrieval-Augmented Generation (RAG) en utilisant gratuitement les outils de l'écosystème Google. Il guide l'utilisateur pas à pas dans la création d'une architecture permettant à un LLM de s'appuyer sur des données externes.
France
· 10/12/2025 13:01 ·
⚙️ 715 tok
Score : 63.0 ⓘ
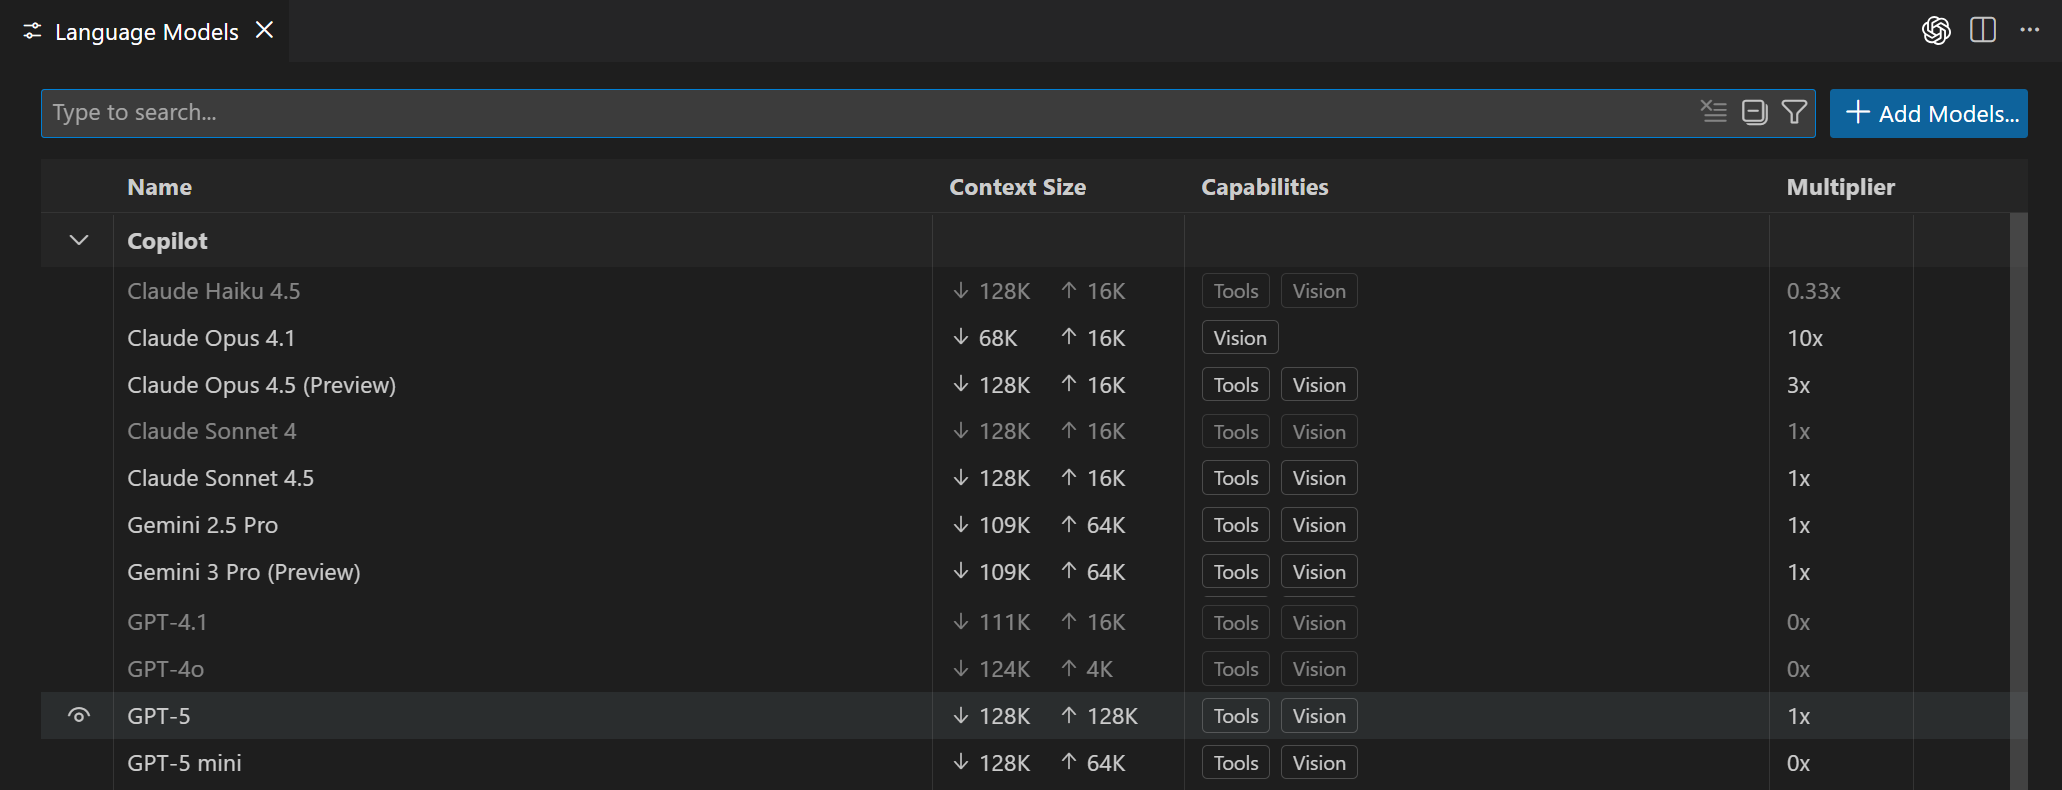
Use your own language model key in VS Code
📖 Lire sur Vigie24Visual Studio Code introduit désormais la possibilité pour les utilisateurs d'utiliser leurs propres clés d'API pour les modèles de langage. Cette fonctionnalité permet une plus grande flexibilité et un contrôle accru sur le choix et le coût des modèles d'IA intégrés à l'éditeur.
États-Unis
· 01/01/0001 00:00 ·
⚙️ 808 tok
Score : 63.0 ⓘ

v0.35.1-rc0: create: support explicit model capabilities (#18708)
📖 Lire sur Vigie24L'outil Ollama publie une version candidate (v0.35.1-rc0) introduisant la possibilité de définir explicitement les capacités des modèles lors de leur création. Cette mise à jour permet un meilleur contrôle sur les fonctionnalités supportées par les modèles LLM locaux.
États-Unis
· 01/01/0001 00:00 ·
⚙️ 990 tok
Score : 52.0 ⓘ