Entrainement Ia
21 article(s)
There’s only one way to stop AI stealing your business data
📖 Lire sur Vigie24L'article alerte sur la collecte massive de données d'entreprise par les laboratoires d'IA pour l'entraînement de leurs modèles. Il propose des stratégies pour protéger les informations confidentielles contre l'exploitation par les géants de la tech.
 Suisse
· 07/10/2026 17:21 ·
⚙️ 978 tok
Score : 69.9 ⓘ
Anthropic veut entraîner Claude avec votre voix : voici le nouveau réglage à connaître
📖 Lire sur Vigie24Anthropic introduit une nouvelle option permettant d'utiliser les conversations vocales des utilisateurs pour entraîner ses modèles Claude. Bien que facultatif, le refus du partage vocal n'exclut pas nécessairement l'utilisation des transcriptions textuelles.
 France
· 06/10/2026 09:41 ·
⚙️ 1 060 tok
Score : 73.0 ⓘ
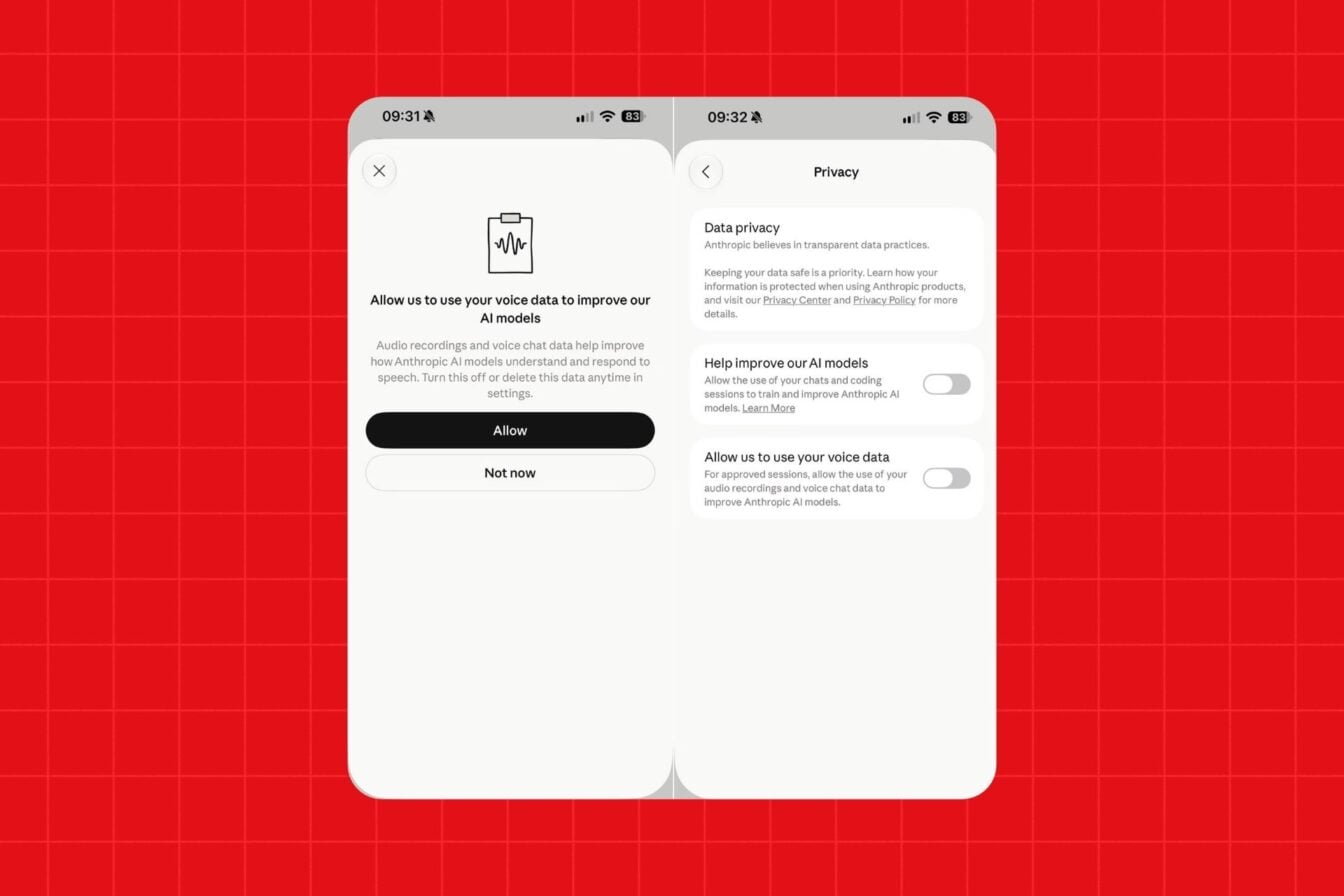
Pour entraîner Claude, Anthropic veut votre voix
📖 Lire sur Vigie24Anthropic sollicite désormais l'autorisation de ses utilisateurs pour utiliser leurs enregistrements vocaux afin d'entraîner les modèles Claude. Ce changement marque un revirement par rapport aux engagements de confidentialité de l'entreprise formulés six mois auparavant.
France
· 06/10/2026 06:28 ·
⚙️ 1 012 tok
Score : 75.0 ⓘ
How your everyday activity feeds Amazon AI training models
📖 Lire sur Vigie24L'article détaille comment Amazon utilise les données issues d'Alexa, Twitch, Ring et Fire TV pour entraîner ses modèles d'IA. Il explique les mécanismes de collecte de données comportementales et propose des méthodes pour limiter ce suivi.
Suisse
· 05/10/2026 18:17 ·
⚙️ 993 tok
Score : 72.3 ⓘ


Court Says AI Cannot Train With Copyrighted Data - Talking Heads Ep.452
📖 Lire sur Vigie24L'article traite d'une décision judiciaire stipulant que l'entraînement des modèles d'IA ne peut se faire sans l'autorisation des détenteurs de droits d'auteur. Cette décision marque un tournant juridique majeur pour les entreprises de l'IA générative.
 États-Unis
· 30/09/2026 23:35 ·
⚙️ 960 tok
Score : 73.5 ⓘ
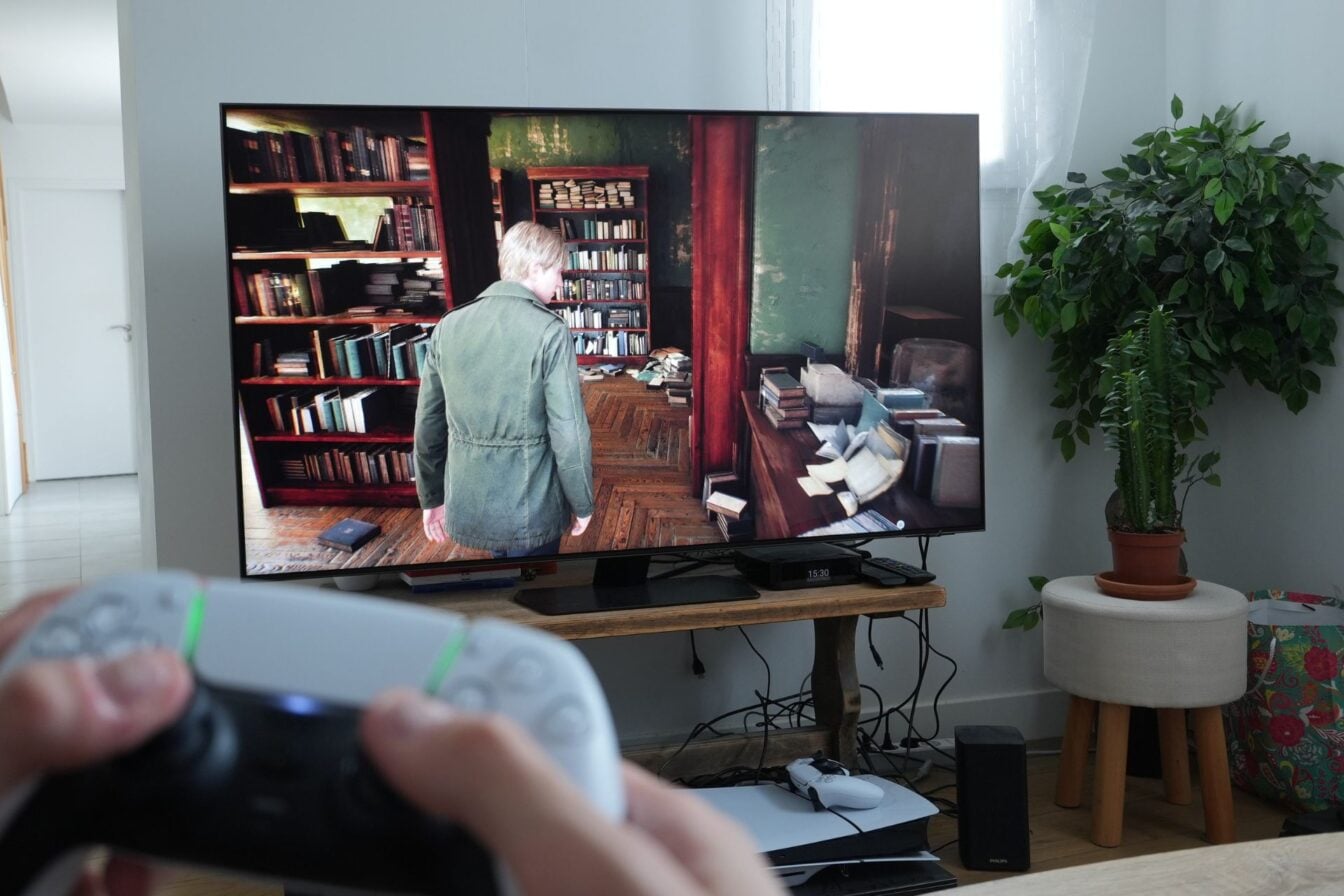
L’IA pourrait s’intéresser de près à vos parties de jeux vidéo
📖 Lire sur Vigie24Une startup de Cambridge a constitué une base de données massive de parties de jeux vidéo. Ces données sont destinées à entraîner des IA pour optimiser le comportement des robots et des véhicules autonomes dans le monde réel.
France
· 29/09/2026 04:31 ·
⚙️ 1 004 tok
Score : 75.0 ⓘ


OpenAI suspend l'entraînement de ses « modèles les plus performants ».
📖 Lire sur Vigie24OpenAI a suspendu l'entraînement de ses modèles d'IA les plus avancés. Cette décision marque un tournant dans le rythme de développement des LLM de pointe.
France
· 26/09/2026 20:01 ·
⚙️ 979 tok
Score : 76.6 ⓘ

Des prestataires chargés de former l'IA d'OpenAI ont été licenciés pour avoir utilisé l'IA afin de former l'IA, car la révision humaine est nécessaire pour empêcher un « effondrement du modèle »
📖 Lire sur Vigie24OpenAI a licencié des prestataires ayant utilisé l'IA pour entraîner ses propres modèles au lieu d'effectuer une révision humaine. Cette pratique est proscrite pour éviter l'effondrement du modèle et garantir que l'IA devienne plus humaine.
France
· 25/09/2026 11:41 ·
⚙️ 1 195 tok
Score : 80.5 ⓘ
Oui, il y a vraiment des humains chez OpenAI qui lisent vos conversations sur ChatGPT
📖 Lire sur Vigie24OpenAI a déployé le « Project Lily », mobilisant une centaine de prestataires pour relire et noter les conversations des utilisateurs de ChatGPT. Ces pratiques de contrôle qualité s'effectuent sans information détaillée auprès des utilisateurs concernés.
France
· 15/09/2026 06:42 ·
⚙️ 1 053 tok
Score : 79.7 ⓘ
Meta accusé d’avoir volé des milliers de films X pour entraîner ses IA, l’un de ses cadres directement impliqués
📖 Lire sur Vigie24Meta est visé par une plainte de 446 millions de dollars pour avoir utilisé illégalement des milliers de films pornographiques pour entraîner ses IA. L'entreprise nie toute implication institutionnelle, attribuant les faits à un piratage personnel d'un de ses cadres.
France
· 08/09/2026 18:00 ·
⚙️ 1 499 tok
Score : 75.0 ⓘ

« Je refuse de former l'IA qui va me remplacer », lancent des travailleurs soucieux de protéger leurs emplois, mais qui oublient qu'ils perdent le contrôle sur la qualité des productions de l'IA
📖 Lire sur Vigie24De nombreux travailleurs et syndicats refusent de fournir leurs données pour l'entraînement des IA afin de protéger leurs emplois. L'article souligne toutefois que ce refus prive les humains de tout contrôle sur la qualité et l'éthique des productions futures de l'IA.
France
· 08/09/2026 14:05 ·
⚙️ 1 340 tok
Score : 75.0 ⓘ

Bruxelles demande aux éditeurs si le mécanisme de refus de l'IA de Google est utile
📖 Lire sur Vigie24La Commission européenne interroge les éditeurs de presse sur l'efficacité du mécanisme de Google permettant de refuser l'utilisation de leurs contenus pour l'entraînement de l'IA. Cette initiative vise à évaluer si cet outil respecte les droits d'auteur et les régulations européennes.
France
· 02/09/2026 09:06 ·
⚙️ 1 022 tok
Score : 68.0 ⓘ
Sony et Warner Music attaquent Anthropic en justice : voici de quoi le créateur de Claude est accusé
📖 Lire sur Vigie24Sony et Warner Music poursuivent Anthropic en justice pour l'utilisation non autorisée de contenus protégés par le droit d'auteur dans l'entraînement de Claude. Cette action s'ajoute à d'autres litiges similaires déjà rencontrés par l'entreprise.
France
· 31/08/2026 12:31 ·
⚙️ 1 718 tok
Score : 79.3 ⓘ

Sony Music et Warner Music poursuivent en justice la société d'IA Anthropic, l'accusant d'avoir utilisé illégalement des milliers d'œuvres musicales protégées par le droit d'auteur
📖 Lire sur Vigie24Sony Music et Warner Music ont intenté une action en justice contre Anthropic aux États-Unis. Ils accusent la société d'IA d'avoir utilisé illégalement des milliers d'œuvres musicales protégées pour l'entraînement de ses modèles.
France
· 31/08/2026 11:53 ·
⚙️ 1 203 tok
Score : 80.1 ⓘ
IA générative : impossible de savoir quelle image a vraiment servi de modèle
📖 Lire sur Vigie24Des chercheurs ont démontré qu'il est pratiquement impossible d'identifier précisément quelle image d'entraînement a influencé la génération d'un contenu spécifique par une IA. Cette difficulté d'attribution s'accentue proportionnellement à la taille du jeu de données utilisé pour l'entraînement des modèles de diffusion.
France
· 29/08/2026 15:00 ·
⚙️ 1 676 tok
Score : 74.2 ⓘ
Dans des entrepôts d'entreprises comme Amazon ou Anthropic, on trouve des machines qui automatisent la destruction de « tous les livres physiques du monde » et leur numérisation, pour entraîner l'IA.
📖 Lire sur Vigie24Des entreprises comme Amazon et Anthropic utilisent des processus automatisés de destruction et de numérisation de livres physiques. L'objectif est de constituer des bases de données massives pour l'entraînement de leurs modèles d'intelligence artificielle.
France
· 28/08/2026 05:59 ·
⚙️ 1 278 tok
Score : 80.5 ⓘ

Projet Panama : des livres broyés pour entraîner l'IA 📚
📖 Lire sur Vigie24Le Projet Panama consiste à numériser massivement des livres physiques en les broyant pour en extraire le texte via des scanners haute performance. Cette méthode vise à constituer des bases de données gigantesques pour l'entraînement des modèles d'intelligence artificielle.
France
· 26/08/2026 15:49 ·
⚙️ 955 tok
Score : 75.0 ⓘ
Amazon est accusé d’avoir récolté les données des utilisateurs Twitch sans leur accord
📖 Lire sur Vigie24Amazon et Twitch font l'objet d'une plainte collective déposée par un streamer. L'entreprise est accusée d'avoir utilisé les données des utilisateurs sans leur consentement pour entraîner un nouveau modèle d'intelligence artificielle.
France
· 24/08/2026 09:00 ·
⚙️ 1 178 tok
Score : 80.1 ⓘ
Amazon a utilisé Twitch comme réservoir de données pour son IA, ce créateur riposte en justice
📖 Lire sur Vigie24Un créateur de contenu a lancé une action en justice contre Twitch et Amazon, les accusant d'avoir utilisé ses vidéos sans consentement pour entraîner des IA génératives. Cette affaire souligne les tensions croissantes autour de l'utilisation des données personnelles pour le machine learning.
France
· 24/08/2026 07:40 ·
⚙️ 742 tok
Score : 80.5 ⓘ

Kimi aurait-il été entraîné grâce à Claude ? #claude #kimi
📖 Lire sur Vigie24L'article s'interroge sur la possibilité que le modèle Kimi ait été entraîné en utilisant des données provenant de Claude. Cette hypothèse soulève des questions sur les pratiques de distillation de modèles d'IA.
France
· 28/07/2026 12:28 ·
⚙️ 694 tok
Score : 52.0 ⓘ

Les 4 étapes pour entrainer un LLM
📖 Lire sur Vigie24Ce contenu détaille le processus technique d'entraînement d'un grand modèle de langage (LLM) en quatre phases distinctes. Il explique le passage du pré-entraînement massif à l'ajustement fin pour rendre le modèle utilisable et sécurisé.
France
· 25/04/2025 15:00 ·
⚙️ 614 tok
Score : 63.0 ⓘ